
La parola “headless” circola da anni nelle conversazioni tra sviluppatori, product manager e CTO. Eppure, chiedendo in giro cosa significhi davvero, le risposte cambiano ogni volta: chi parla di CMS, chi di e-commerce, chi di server senza schermo.
Il concetto di “headless” indica un’architettura software che separa ciò che il sistema fa, cioè gestire dati, regole e processi, dalle interfacce attraverso cui viene utilizzato, come siti, app o portali.
È una configurazione che esiste da ben prima che l’AI diventasse uno strumento realmente utilizzato nel business.
In passato ha risposto soprattutto all’esigenza di separare contenuti e servizi dai canali attraverso cui venivano presentati.
Chi ha già incontrato il termine probabilmente lo associa a sviluppi legati al CMS o all’ecommerce.
L’associazione resta valida, ma oggi descrive solo una parte del concetto.
Con l’AI, infatti, l’architettura headless non serve più soltanto a distribuire lo stesso motore su più interfacce: cambia proprio chi può usarlo.
Le persone possono accedere, tramite interfacce conversazionali, ai dati e ai processi per cui sono autorizzate, formulando una richiesta in linguaggio naturale senza passare da una schermata prestabilita.
Ma accanto alle persone e alle applicazioni, arrivano anche gli agenti AI a utilizzare i software: grazie all’headless, diventano capaci di richiamare API, strumenti MCP e processi autorizzati in autonomia.
Il principio headless diventa così rilevante anche per CRM e sistemi enterprise, dove dati, workflow, regole e permessi possono essere utilizzati da portali, app e agenti diversi.
Questo articolo chiarisce che cos’è l’architettura headless oggi, come è cambiata con gli agenti AI e quale opportunità apre per software diversi dal CMS, in particolare per il CRM, dove le aziende conservano (e spesso disperdono) un vero e proprio patrimonio di dati e informazioni.
Il White Paper Gunpowder L’era headless di Salesforce ha inizio approfondisce il passaggio dall’interfaccia al motore, le possibili strade architetturali e il lavoro necessario per rendere dati e processi utilizzabili dagli agenti.
Che cos’è headless e come funziona un’architettura headless
In informatica, headless significa che il back-end di un software è separato dal front-end, la “testa” che presenta dati e funzioni all’utente. Attraverso le API, lo stesso back-end può rendere disponibili dati e funzionalità a più utilizzatori indipendenti: siti, app, portali, altri software e, oggi, interfacce conversazionali e agenti AI.
Un sistema headless può avere quindi molte interfacce.
“Senza testa” indica che il back-end non incorpora un’unica interfaccia obbligatoria: il livello di presentazione viene progettato separatamente e può essere sostituito, aggiornato o affiancato da altri front-end senza ricostruire il sistema centrale. È questa indipendenza a distinguere l’architettura headless da un’applicazione in cui interfaccia e motore sono sviluppati come un unico insieme.
Il front-end presenta le informazioni e raccoglie le richieste dell’utente. Il back-end conserva i dati, applica autorizzazioni e regole di business, esegue i processi e restituisce un risultato.
Le API funzionano da porta tra i due livelli: quando un sito, un’app o un altro utilizzatore invia una richiesta, il back-end verifica che sia consentita, svolge l’operazione e restituisce soltanto i dati o le funzioni previsti.
Il principio resta lo stesso in contesti diversi.
- In un headless CMS, il back-end gestisce e archivia i contenuti, mentre siti e app decidono come presentarli.
- Nell’headless e-commerce, il motore conserva catalogo, prezzi, carrello, ordini e pagamenti, che possono alimentare vetrine differenti.
- In un headless CRM, a essere resi accessibili sono dati, logiche, workflow e permessi.
- API e strumenti MCP permettono anche agli agenti AI di usare queste capacità, mentre le interfacce conversazionali consentono alle persone di richiamarle in linguaggio naturale.
Per chiarire meglio questo funzionamento, può essere utile un esempio quotidiano.
La metafora del ristorante per capire l’headless
Immaginiamo un ristorante.
- La sala comprende il menù, i tavoli e il modo in cui viene raccolto l’ordine.
- La cucina contiene ingredienti, ricette, attrezzature e regole di preparazione.
Nel software, la sala corrisponde all’interfaccia; la cucina è il motore che conserva informazioni ed esegue il lavoro.
In un sistema tradizionale, sala e cucina sono progettate come un insieme. Chi vuole usare il servizio entra dalla sala prevista e ordina attraverso le interfacce predisposte (i camerieri, il menu).
L’architettura headless allenta questo legame: la stessa cucina può ricevere ordini da più sale, da un’app o da un servizio esterno.
Le interfacce continuano a esistere e possono essere molte, mentre il motore resta unico.
Un’azienda può così progettare esperienze diverse per operatori, clienti e partner, continuando a usare le capacità centrali già costruite.
Ogni pubblico raggiunge soltanto le parti autorizzate dello stesso sistema.
Come funzionava l’architettura headless prima dell’AI
Prima degli agenti AI, l’headless serviva soprattutto a distribuire gli stessi contenuti, dati o servizi su esperienze diverse. Ogni nuovo canale era progettato da persone per altre persone.
Perché sono nati headless CMS e headless e-commerce
Il caso d’uso più conosciuto (almeno finora) è l’headless CMS. I contenuti vengono gestiti in un archivio centrale e distribuiti a siti, app o altri canali attraverso API.
Nell’headless e-commerce accade qualcosa di simile con cataloghi, prezzi e ordini: la vetrina può cambiare senza ricostruire il motore commerciale.
Immaginiamo un rivenditore che voglia affiancare al sito un’app e uno schermo interattivo in negozio. Le tre interfacce possono presentare catalogo e percorsi differenti, continuando a interrogare lo stesso sistema di prodotti, prezzi e disponibilità. Quando un dato cambia nel back-end, ogni canale può recuperare la versione aggiornata.
L’azienda evita di creare un archivio per ogni canale e può cambiare un’esperienza senza ricostruire il sistema degli ordini.
Il percorso resta però definito in anticipo e pensato per le persone: qualcuno decide che cosa mostrare, quale API interrogare e quale processo avviare dopo ogni azione dell’utente.
Il limite delle interfacce progettate per le persone ai tempi dell’AI
Una schermata limita molto le possibilità offerte, senza che ce ne accorgiamo consciamente.
Mostra le azioni disponibili, segnala i campi obbligatori, nasconde ciò che l’utente non può vedere e impedisce alcuni passaggi.
Finché l’utilizzatore è una persona, la “sala” serve a guidarla lungo un percorso stabilito.
L’AI cambia questo presupposto. Quando il nuovo utilizzatore è un altro software (come un agente AI), questo può ricevere un obiettivo e decidere quali capacità richiamare in base al contesto.
Per riuscirci, deve conoscere gli strumenti disponibili e i confini entro cui può usarli, ma soprattutto deve avere accesso a dati, informazioni e strumenti utili al compito distribuiti tra software diversi.
Come cambia l’architettura headless con gli agenti AI
In un software tradizionale, molte capacità sono raggiungibili attraverso elementi dell’interfaccia: un pulsante per approvare, un modulo per aggiornare una pratica, una sequenza di schermate per avviare un workflow.
Con l’headless, quelle stesse capacità vengono esposte come operazioni richiamabili tramite API.
Ogni operazione può avere dati richiesti, risultato atteso, permessi e regole di validazione.
Questo è fondamentale per un agente AI.
Metadati e strumenti MCP gli descrivono quali operazioni esistono, che cosa fanno e come usarle. L’agente può quindi scegliere la capacità adatta all’obiettivo e richiamarla direttamente grazie all’architettura headless, senza simulare i clic di una persona.
Lo stesso meccanismo può servire una persona attraverso un’interfaccia conversazionale, come una chat con lo strumento AI di fiducia collegato ai software aziendali o altre applicazioni lavorative: la richiesta formulata in linguaggio naturale viene tradotta in una chiamata alle capacità autorizzate del back-end, e la risposta contiene dati e informazioni rilevanti senza bisogno di andare a cercarle tra le schermate.
Dall’integrazione fissa alla scelta dinamica degli strumenti
Un’integrazione tradizionale segue un percorso deciso in fase di sviluppo. Per esempio, i dati inviati da un modulo vengono copiati nel CRM secondo regole prestabilite. L’azione e il momento in cui eseguirla sono già scritti nel flusso.
Un agente riceve invece un obiettivo. Immaginiamo, come esempio ipotetico, la richiesta “prepara il rinnovo di contratto del cliente X”.
L’agente può verificare il contratto nel CRM, recuperare un documento da Drive, controllare la corrispondenza recente e predisporre la pratica. La sequenza dipende da ciò che trova e dagli strumenti a cui ha accesso.
Ogni sistema mantiene il proprio ruolo. Drive espone i documenti, la posta i messaggi, il CRM dati e processi autorizzati. L’agente coordina gli strumenti e riporta il risultato nel punto previsto.
L’headless crea quindi una condizione utile all’agente, senza rendere automaticamente agentico il sistema.
Headless, API e MCP: quali differenze
Headless, API e MCP vengono spesso usati come se indicassero la stessa cosa.
Appartengono invece a livelli differenti.
La metafora della cucina aiuta a distinguerli e chiarire cosa sono.
Headless, API, MCP e agenti a confronto
| Elemento | Che cos’è | Nella metafora | Che cosa fa |
|---|---|---|---|
| Headless | Un modello architetturale | La cucina può servire più sale | Separa il motore da una singola interfaccia |
| API | Un’interfaccia tecnica tra software | Una porta di servizio con regole precise | Permette a un software di richiedere dati o azioni |
| MCP | Un protocollo per applicazioni AI | Una porta accompagnata da un menù leggibile dall’agente | Descrive strumenti e risorse che l’agente può scoprire e usare |
| Agente AI | Un utilizzatore software | Un assistente autorizzato a ordinare e coordinare attività | Sceglie gli strumenti in base all’obiettivo e al contesto |
Cosa cambia tra API, MCP e architettura headless quindi?
Un’API definisce come due software comunicano. Può servire a copiare un dato tra sistemi, alimentare un’app o avviare un processo.
MCP interviene a un altro livello, ovvero permette al server di presentare strumenti e risorse secondo uno standard che un’applicazione AI può interrogare, con le API sottostanti che continuano a recuperare dati o eseguire azioni.
In altre parole, MCP rende le capacità individuabili e utilizzabili dall’AI, mentre le API svolgono il lavoro operativo.
La relazione diventa headless quando un’esperienza esterna usa il back-end senza dipendere dall’interfaccia originaria.
Un agente può quindi scoprire uno strumento tramite MCP e attivare, attraverso quello strumento, una funzione eseguita da un’API.
Headless descrive l’architettura complessiva, API e MCP sono due dei meccanismi che rendono accessibile il motore.
Che cos’è un headless CRM e come funziona
Un headless CRM è l’evoluzione del concetto di headless, applicata al software che forse più di tutti ha da beneficiare dall’apertura dei suoi confini: il CRM.
Rendendo i dati contenuti al suo interno accessibili tramite API e MCP, dati, logica e processi dono utilizzabili da interfacce diverse.
Il motore continua a gestire anagrafiche, casi, opportunità, autorizzazioni e workflow, e la console diventa uno dei punti di accesso. Portali, app e agenti raggiungono le capacità autorizzate attraverso API o altri strumenti della piattaforma.
Come un Headless CRM cambia il processo decisionale
Immaginiamo una direttrice commerciale che voglia sapere quali opportunità aperte nel suo CRM (Salesforce) non registrano attività o avanzamenti da più tempo, quale valore economico rappresentano e se si concentrano in una determinata area, linea di prodotto o tipologia di cliente.
Se possiede i permessi e le capacità per creare e modificare report, può costruirlo e consultarlo direttamente in Salesforce.
Ma questa risposta apre altre domande: a quando risale l’ultimo contatto, quante volte è stata rinviata la data di chiusura, esiste una proposta aggiornata e i decisori coinvolti hanno risposto alle ultime comunicazioni? E così via.
A quel punto, per combinare informazioni distribuite tra oggetti e sistemi diversi, verificare che siano confrontabili e ricostruire il quadro d’insieme, serve una grande padronanza degli strumenti e/o l’aiuto di altri team. Ma ogni passaggio aggiunge tempo e distanza.
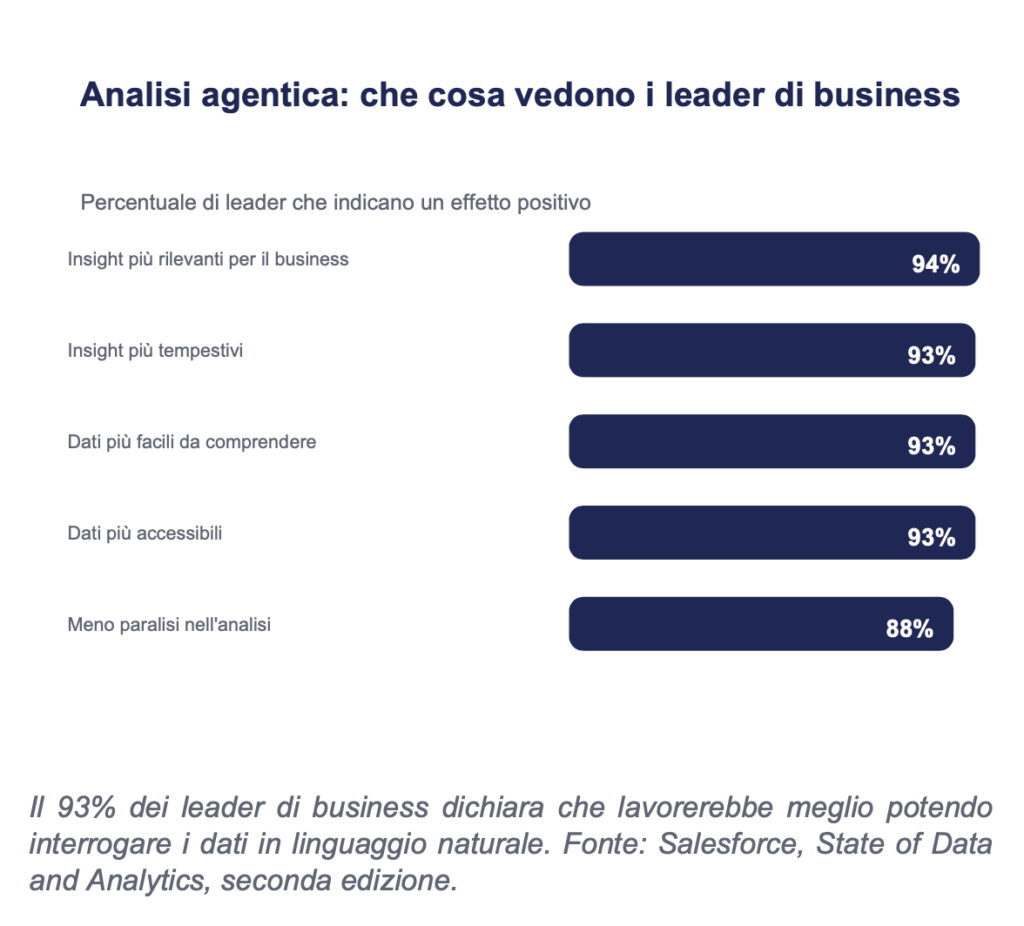
Per ricerche più articolate, con un’architettura headless la direttrice può usare gli strumenti AI aziendali integrati in Salesforce e nelle altre applicazioni, evitando di affidare ogni richiesta a uno strumento di BI aggiuntivo o a un’estrazione puntuale preparata dall’IT.
Non solo, in base a quali strumenti sono stati collegati può anche confrontare dati su ambienti diversi. Si può ad esempio partire da un file Excel con il budget 2026 del portafoglio clienti e aggiornarlo periodicamente con il booking registrato in Salesforce per gli stessi clienti.
In questo modo è possibile mettere in relazione il piano commerciale con l’andamento delle opportunità, usando nella stessa analisi dati aziendali, file e altri contenuti autorizzati.
Le analisi servono poi a interpretare i dati.
L’AI può produrre commenti e suggerimenti di lettura, oltre a PowerPoint e documenti già pronti per presentare i risultati commerciali al board.
La possibilità di un accesso conversazionale con i dati racchiusi nel CRM amplia il lavoro della manager in tre direzioni, quindi:
- interrogare i dati,
- confrontarli con fonti diverse
- e trasformare la lettura in un output utilizzabile.
È un esempio concreto di come l’esperienza del management, e non solo, possa migliorare drasticamente con questi strumenti.
Headless 360: un esempio di architettura headless di Salesforce
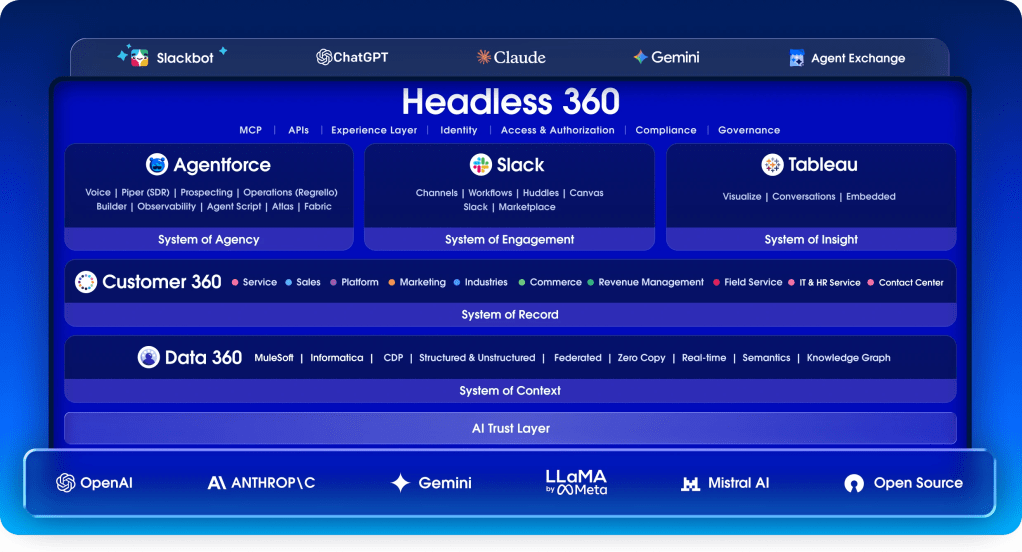
Headless 360 è il primo e più strutturato esempio di svolta nella direzione headless di un software gestionale e CRM.
Salesforce dava accesso già negli anni passati ad API e progetti con front-end esterni.
L’iniziativa Headless 360, annunciata ad aprile 2026, amplia e organizza l’accesso alla piattaforma attraverso API, strumenti MCP e comandi utilizzabili da agenti e applicazioni.
Come cambia l’accesso alle funzioni di Salesforce con Headless 360
L’annuncio di Headless 360 è stato dato con una frase provocatoria:
“perché dovresti ancora accedere a Salesforce?“.
In realtà l’accesso headless non implica che le interfacce tradizionali non esistano più, anzi: amplia le possibilità di accesso agli stessi dati, non le limita.
La console storica continua a poter essere utilizzata dagli operatori che devono vedere record, cronologia e vincoli.
Ma accanto ad essa possono esistere un portale, un’app o un agente esterno che accedono in modalità headless agli stessi dati.
Il back-end resta Salesforce; cambia la superficie che ne richiama le capacità.
Lo stesso principio vale per altri sistemi enterprise con dati, workflow e regole da riutilizzare.
Quando conviene scegliere un’architettura headless
L’headless è utile quando le stesse capacità devono raggiungere esperienze o utilizzatori diversi. La scelta ha meno senso con un solo canale stabile, un’interfaccia già adeguata e costi architetturali superiori al problema da risolvere.
I casi in cui l’headless può essere utile
Prima di valutare tecnologie e fornitori, conviene osservare il processo. I segnali più rilevanti sono questi:
- clienti, dipendenti o partner hanno bisogno di interfacce differenti sopra gli stessi dati;
- il CRM contiene regole e workflow che devono essere riutilizzati da un portale, un’app o un agente;
- un’attività attraversa più sistemi e richiede un punto di coordinamento;
- la console standard costringe alcuni utenti a entrare in un ambiente più complesso del necessario;
- dati, permessi e responsabilità sono abbastanza chiari da poter essere esposti in modo controllato.
Le condizioni da verificare prima del progetto
Una valutazione iniziale può partire da cinque domande operative:
- Quale capacità del sistema deve essere raggiunta da una nuova interfaccia o da un agente?
- Chi può leggerla, usarla o modificarla?
- Quali dati e strumenti servono per completare il compito?
- In quali passaggi è richiesta una decisione umana?
- Come si osserva l’esecuzione e come la si interrompe quando esce dal perimetro?
Le risposte aiutano a capire se serve un’architettura headless, una singola integrazione o un intervento preliminare sui processi.
Aiutano anche a delimitare il primo caso d’uso per un pilot, evitando di partire da un processo troppo complesso, poco strutturato o che potrebbe beneficiare di più di un altro tipo di intervento.
Cosa significa Headless per le aziende che usano Salesforce
Per le aziende che usano CRM potenti ma complessi come Salesforce, l’accesso headless significa separare il valore accumulato nel motore dal modo in cui viene presentato.
In questo modo, tutto il patrimonio informativo che l’organizzazione ha accumulato negli anni (informazioni, dati, processi, regole, etc) può essere davvero utilizzato, senza che le persone (o gli agenti AI) siano limitate dalle capacità tecniche e dai vincoli delle schermate.
Il White Paper Gunpowder L’era headless di Salesforce ha inizio approfondisce il passaggio dall’interfaccia al motore, le possibili strade architetturali e il lavoro necessario per rendere dati e processi utilizzabili dagli agenti.
Domande frequenti sull’architettura headless
Che cos’è un’architettura headless?
È un’architettura software che separa il front-end dal back-end. Dati, logica e processi restano nel motore, mentre siti, app, portali o agenti possono usarli attraverso accessi definiti. L’interfaccia originaria può continuare a esistere accanto alle nuove esperienze.
Headless e headless CMS sono la stessa cosa?
L’headless CMS è un’applicazione del principio headless. Separa la gestione dei contenuti dal modo in cui vengono presentati su siti e canali diversi. Lo stesso modello può essere applicato a e-commerce, CRM e altri sistemi enterprise.
Qual è la differenza tra headless, API e MCP?
Headless descrive la separazione tra motore e interfaccia. Un’API stabilisce come due software si scambiano dati o richiamano funzioni. MCP presenta strumenti e risorse in una forma che le applicazioni AI possono scoprire e usare, appoggiandosi spesso alle API per eseguire le operazioni.
Perché l’AI rende l’architettura headless più utile?
Un agente AI può richiamare direttamente dati e funzioni senza attraversare una schermata progettata per una persona. Può inoltre scegliere tra più strumenti in base all’obiettivo e al contesto. L’architettura headless rende il motore raggiungibile, mentre permessi, regole e supervisione definiscono ciò che l’agente può fare.